


Четвероногий робот научился прыгать через узкие проходы
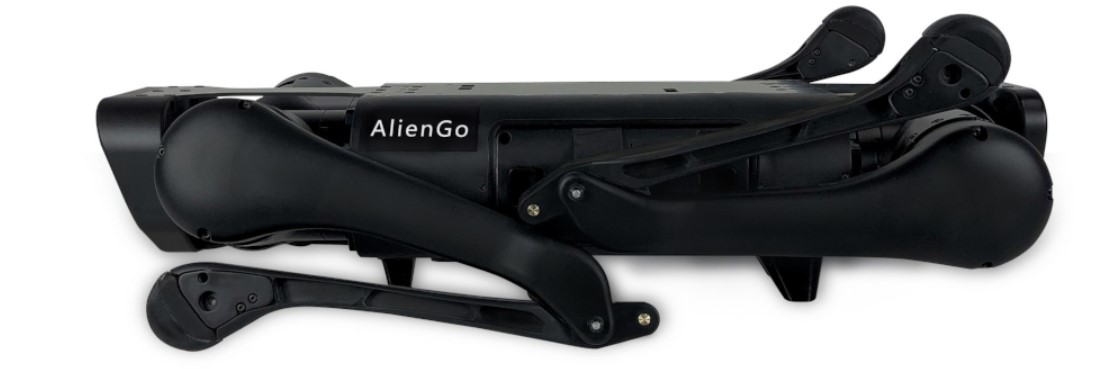
Четвероногий робот Unitree Aliengo научился самостоятельно находить узкий проём, разгоняться и перепрыгивать его в воздухе, полагаясь только на бортовое зрение. Разработка принадлежит исследователям из Гонконгского университета и Оксфордского института робототехники.
Животные оценивают точку прыжка, принимают решение и поджимают лапы в воздухе без малейших раздумий. Научить тому же самому машину весом 22 кг и было целью команды.
Прыжок как высший пилотаж
Кошки, собаки, волки и другие подвижные четвероногие легко прыгают и протискиваются сквозь узкие щели на высокой скорости. Воспроизвести подобную ловкость в четвероногих роботах до сих пор не удавалось.
Исследователи из Гонконгского университета (HKU) и Оксфордского института робототехники разработали подход к обучению, который позволяет четырёхногому роботу самостоятельно и быстро проходить через узкие ворота. Их метод, описанный в статье, опубликованной в Advanced Robotics Research, сначала опробовали на четвероногом роботе Aliengo.
«Наша группа в лаборатории адаптивного управления роботами (ArcLab) при HKU работает и с летающими, и с шагающими машинами, - рассказал Tech Xplore Пэн Лу, старший автор статьи. - Для дронов пролёт через узкую щель давно считается высшим пилотажем: он заставляет восприятие, принятие решений и управление работать в доли секунды. Мы всё время спрашивали себя, почему никто не поставил такую же задачу перед наземным роботом».
Новая работа профессора Лу и его коллег также опирается на поведение собак. А именно на известную способность пса разогнаться перед обручем, на лету прикинуть точку прыжка, поджать лапы в воздухе и приземлиться уже бегом.
«Четвероногие роботы механически на это способны, но обычно используют лишь малую часть своих аппаратных возможностей, - пояснил Лу. - Поэтому наша цель была в том, чтобы 22-килограммовый робот самостоятельно обнаружил проём примерно своего размера, решил, когда и с какой скоростью прыгать, и пролетел сквозь него - на реальном железе, а не только в симуляции».
Два уровня обучения
Лу и его коллеги из ArcLab разработали новый метод обучения совместно с Иоаннисом Хавутисом из Оксфордского университета. Предложенный подход опирается на два ключевых компонента: контроллер нижнего уровня и сеть-дискриминатор.
«Контроллер нижнего уровня учится двигаться: вместо того чтобы вручную проектировать прыжок, мы даём роботу имитировать данные захвата движений реальной собаки - рысь, галоп, повороты и прыжки - с помощью состязательного обучения имитации, - объяснил Лу. - Сеть-дискриминатор оценивает, похоже ли движение робота на движение животного, и эта оценка становится частью награды».
Вместо того чтобы хранить каждый навык отдельно и обращаться к нему по отдельности, подход команды позволяет навыкам непрерывно смешиваться. В результате переход от медленной ходьбы к полному бегу, прыжку и приземлению с переходом в бег возникает просто из скорости, которую задают роботу.
«Контроллер верхнего уровня затем учится, что делать: работая десять раз в секунду, он смотрит на ворота, обнаруженные бортовой RGB-D камерой, и выдаёт только скорость вперёд и угловую скорость поворота, - сказал Лу. - Это очень маленькое, осмысленное пространство решений, поэтому обучение занимает около шести часов, а не продирается сквозь сырые команды суставов. Самое показательное в реальном роботе - не какая-то отдельная цифра, а то, что машина по-настоящему берёт на себя этот манёвр».
Когда контроллер применили к четырёхногому Aliengo, исследователи заметили, что он разгоняется к воротам до тех пор, пока задние моторы не оказываются близки к насыщению, а затем плотно поджимает лапы в воздухе, чтобы они прошли мимо рамы. Примечательно, что команда никогда не задавала, когда именно нужно отрываться от земли или какие конечности поджимать; робот сам нашёл правильную последовательность действий.
Обобщение вместо заучивания
Новый контроллер и подход к обучению, разработанные этой исследовательской группой, могут приблизить роботов к той ловкости, которую демонстрируют собаки и другие четвероногие животные. Та же обучающая схема потенциально применима и для воспроизведения иных стремительных движений у шагающих машин.
«Насколько нам известно, это одна из первых демонстраций, где шагающий робот самостоятельно прыгает через ограниченное пространство с настоящей фазой полета, и все это подтверждено на реальном оборудовании, а не в симуляции», - говорит Лу.
«Мы обнаружили, что контроллер работает обобщенно, а не просто заучивает одну отрепетированную сцену: ворота можно поставить в любом месте комнаты, на любой высоте в пределах досягаемости робота, и он сам находит свой подход. Для более высокого проема он удлиняет разбег и сильнее сгибает суставы, а если ворота смещены в сторону - пересекает их по диагонали. Он даже справляется, когда ворота передвигают, пока робот уже бежит к ним, перепланируя траекторию на лету».
Еще одно преимущество подхода - библиотека низкоуровневых навыков, на которую он опирается, многоразовая. Это значит, что того же робота можно перенастроить на прыжки через барьеры, вертикальные стены или щели, просто переконфигурировав высокоуровневый модуль, без переобучения политики движения.
«Более широкий смысл - в применении роботов в загроможденных средах человеческого масштаба, таких как обрушенные конструкции и промышленные площадки, где способность решиться на динамичный маневр, а не медленно преодолевать каждое препятствие, - это то, что делает маршрут вообще возможным», - добавляет Лу.
Планы на будущее
Сейчас исследователи планируют дальнейшие работы по улучшению своего метода. Например, предложенный подход по-прежнему полагается на внешнюю систему захвата движения, но они хотят, чтобы робот справлялся с загроможденными пространствами и эффективно перепрыгивал частично скрытые препятствия, опираясь только на данные бортовых датчиков.
«Мы также хотим расширять репертуар навыков, чтобы та же схема охватывала более широкий спектр стесненных рабочих пространств», - говорит Лу.
«Кроме того, схема построена вокруг четвероногого робота, но в ней нет ничего, что было бы специфично именно для четырех ног. Нам интересно, перенесется ли та же структура „сначала подражай, потом решай" на гуманоидов, где фаза полета еще менее простительна».
Теги: четвероногий робот, Unitree Aliengo, прыжки, искусственный интеллект, обучение с подкреплением, робототехника


